一、引言:为什么你的MS/MT EA在回测时越来越慢?
做过多品种多周期(Multi-Symbol / Multi-Timeframe,简称MS/MT)EA开发的人,几乎都遇到过这样的问题:单品种的时候跑得好好的,一扩展到五六个品种、三四个周期,回测速度直接慢了一个数量级。有时候跑着跑着,MT5客户端的内存占用从几百兆涨到几个G,最后直接弹出"Out of Memory"崩溃。更诡异的是,同样的策略逻辑,在M1周期回测10个品种5年数据,居然要跑十几个小时,而单品种只需要十几分钟。
你开始怀疑是不是电脑配置不够,加内存换固态,结果发现问题依然存在。你开始优化代码,把循环里的函数提到外面,减少不必要的计算,但性能提升依然有限。其实很多时候,瓶颈不在CPU计算,而在数据获取和内存管理——每次Tick重复调用CopyRates、反复创建指标句柄、数组越界导致的隐性开销,这些才是拖慢MS/MT EA的真正元凶。
举一个真实的案例:一位社区粉丝投稿的三品种套利EA,在策略测试器中运行半年数据后,MT5内存占用从初始的800MB飙升到4.2GB,最终因内存不足而崩溃。把代码拉出来一看,OnCalculate里每次调用都用iMA重新创建移动平均线句柄,三个品种两个周期就是6个句柄,每根K线创建一次,几年的回测下来创建了几十万次,却从来没有调用IndicatorRelease释放。这就是典型的"句柄泄漏"——表面上代码能跑,实际上内存一直在偷偷流失。
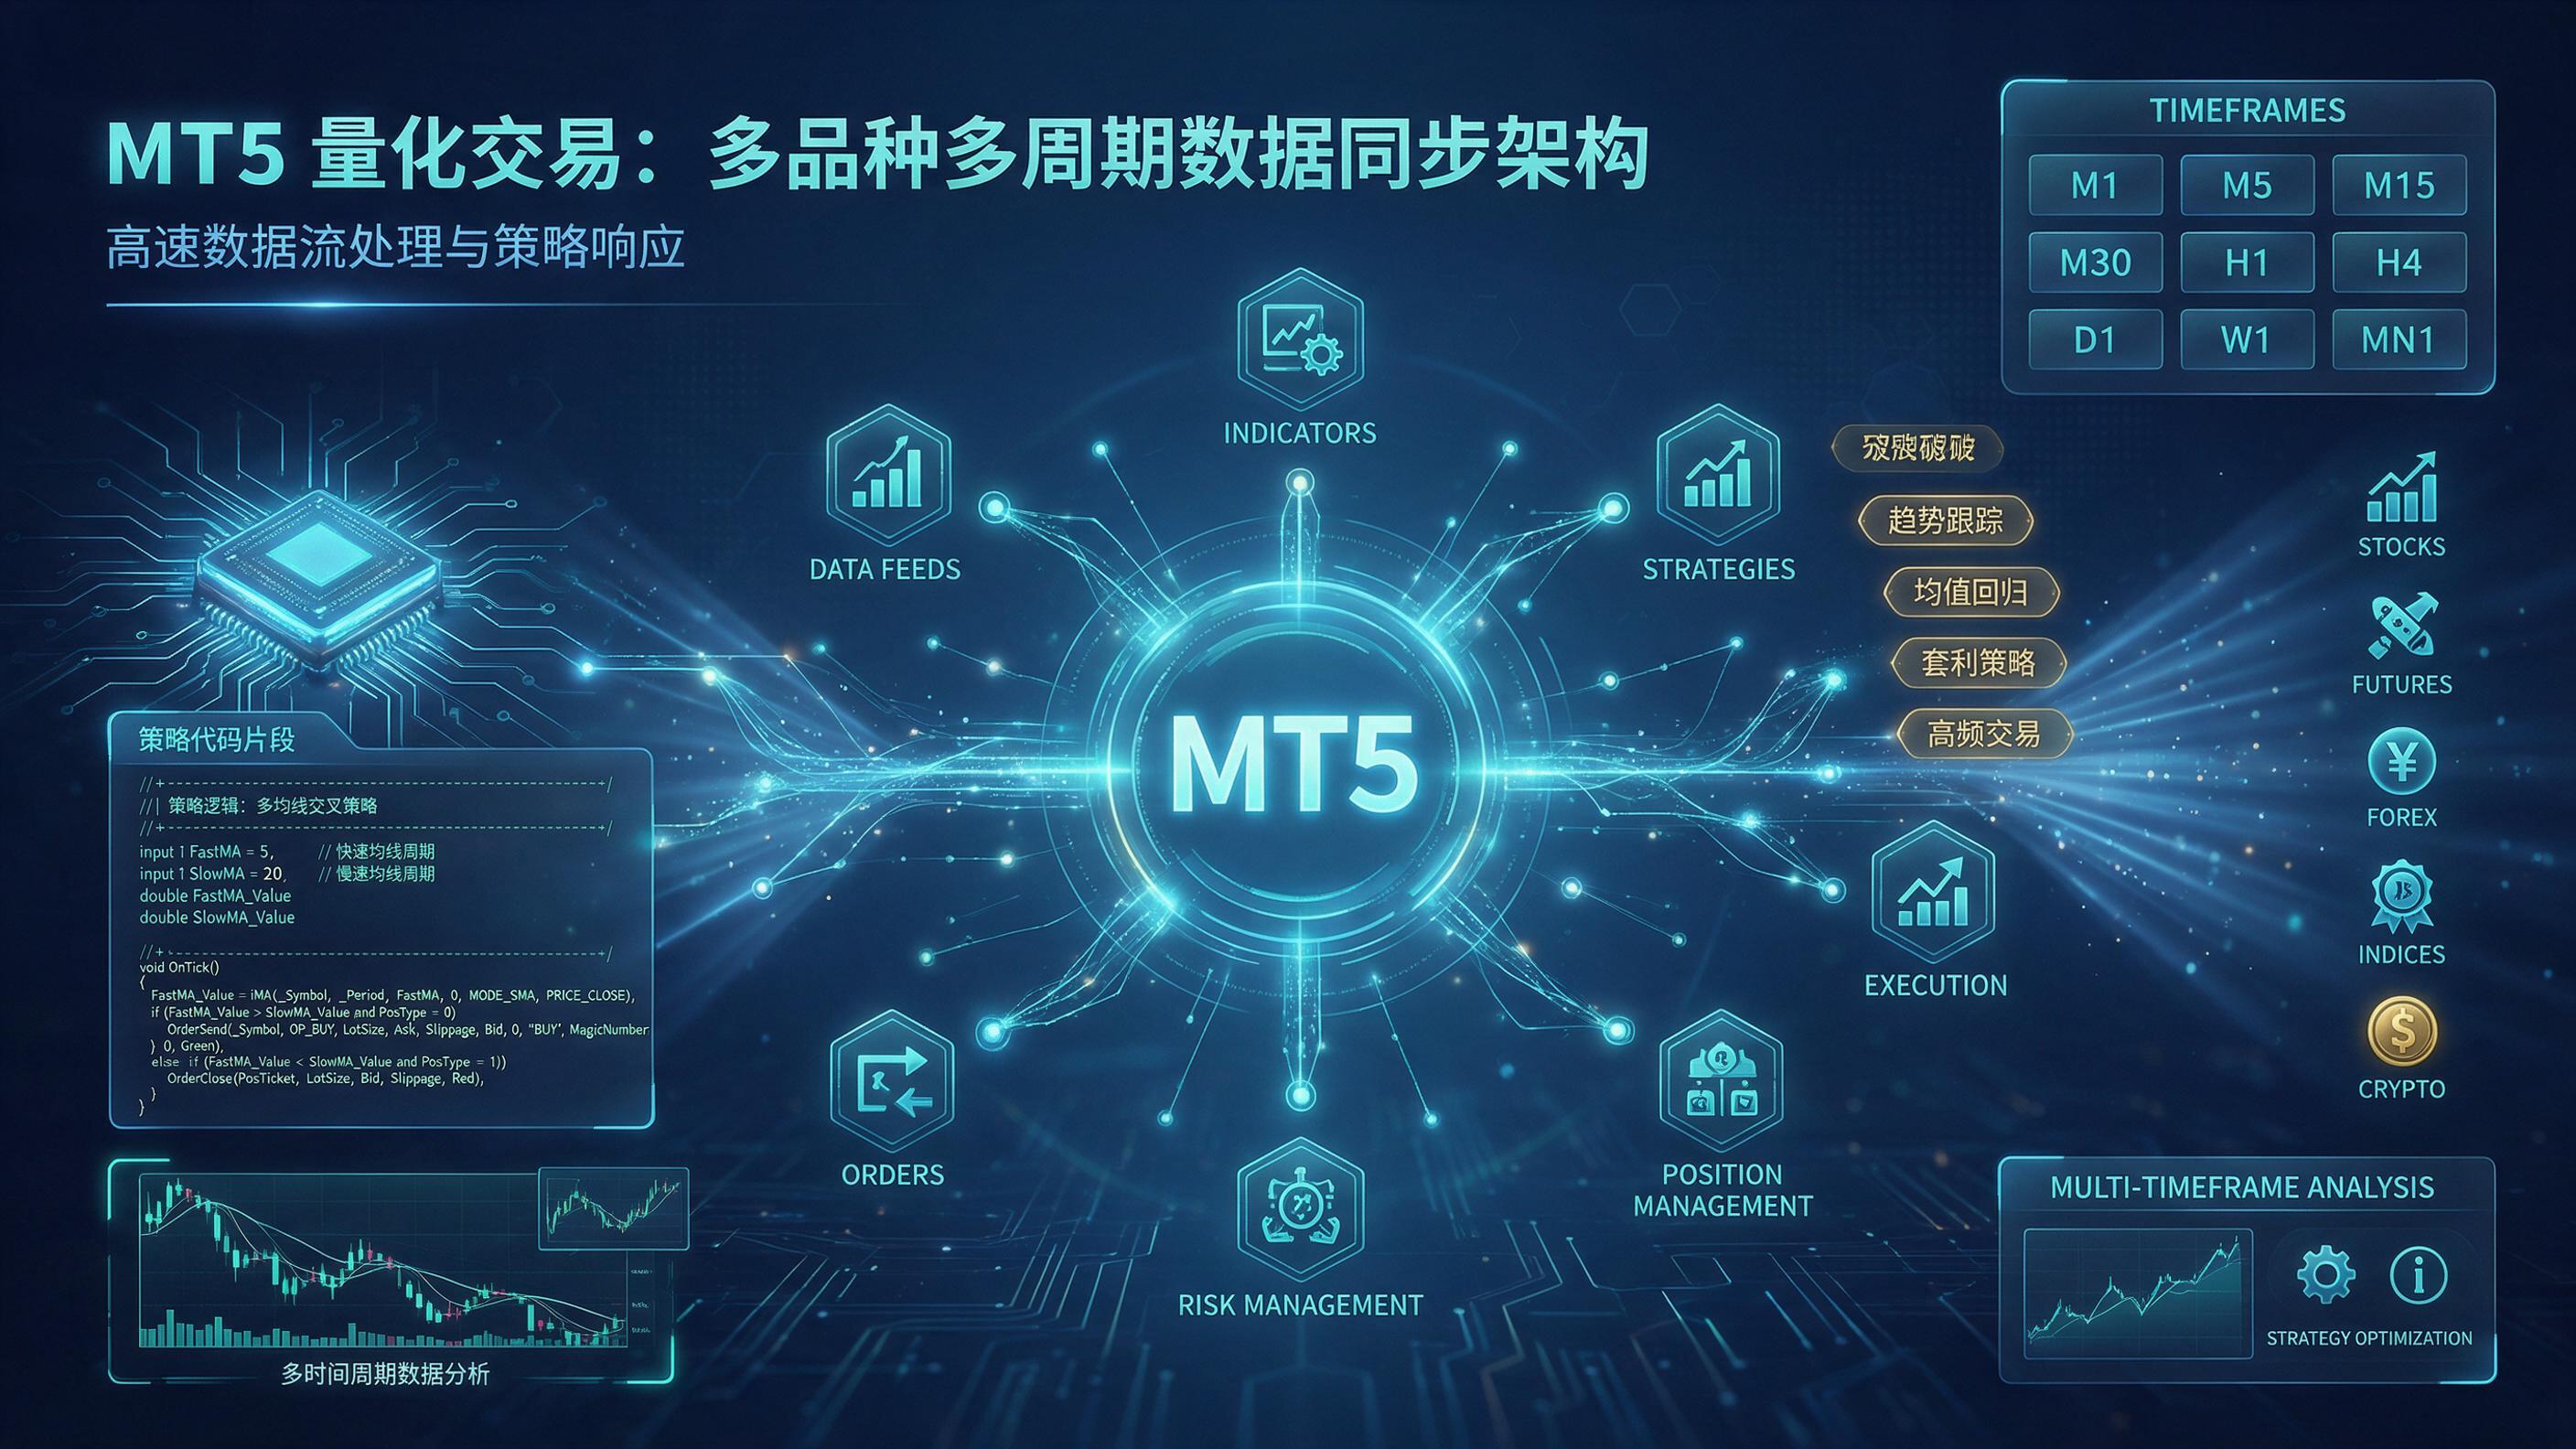
本文将系统拆解MS/MT EA开发中的六大核心痛点:指标句柄泄漏、K线数据不对齐、重复数据获取、并发效率低下、内存监控缺失、架构设计混乱。每一个痛点我们都会深入底层原理,给出可直接复用的代码解决方案,最后提供一套经过实盘验证的MS/MT EA基础框架代码。无论你是正在开发多品种EA遇到性能瓶颈,还是打算从单品种向多品种扩展,这篇文章都能帮你建立完整的性能调优知识体系。
二、核心痛点一:指标句柄的"隐形泄漏"与优雅释放
指标句柄(Indicator Handle)是MQL5中最容易被忽视的内存泄漏源头。很多开发者从MQL4转过来,习惯了直接调用iMA()、iRSI()获取指标值,却不知道在MQL5中,这些函数返回的是一个"句柄"——本质上是指向终端内部指标计算实例的指针。每调用一次创建一个实例,如果不释放,这个实例就会一直占用内存。
iMA() 等函数返回的是 int 类型的句柄,而不是直接的指标数值。要获取具体的指标值,需要再调用 CopyBuffer() 将数据从指标实例复制到本地数组。这种"句柄+复制"的两步设计是MQL5与MQL4的核心差异之一,也是新手最容易踩坑的地方。
我们先来看一个典型的错误示范。很多人写MS/MT EA的时候,为了获取其他品种的指标值,会在OnTick里直接这样写:
// 错误示范:每次Tick都创建新的指标句柄,从不释放
void OnTick()
{
   // 获取EURUSD的H1 MA值
   int ma_handle = iMA("EURUSD", PERIOD_H1, 20, 0, MODE_SMA, PRICE_CLOSE);
   double ma_buffer[];
   CopyBuffer(ma_handle, 0, 0, 1, ma_buffer);
   // 使用 ma_buffer[0] 做交易决策...

   // 再获取GBPUSD的H1 RSI值
   int rsi_handle = iRSI("GBPUSD", PERIOD_H1, 14, PRICE_CLOSE);
   double rsi_buffer[];
   CopyBuffer(rsi_handle, 0, 0, 1, rsi_buffer);
   // 使用 rsi_buffer[0] 做交易决策...
}
这段代码的问题在于:每来一个Tick,就创建2个新的指标句柄。如果是M1周期,一年大约有250个交易日 × 24小时 × 60分钟 = 36万根K线,每根K线就算只有1个Tick,也会创建72万个句柄。每个句柄占用的内存虽然不大(通常几KB到几十KB),但累积起来的总量是惊人的。更严重的是,MT5终端的句柄资源是有限的,当句柄数量达到一定阈值后,终端会变得异常缓慢,甚至无法创建新的指标实例。
正确的做法是:在OnInit中一次性创建所有需要的指标句柄,在OnDeinit中统一释放。中间的OnTick只负责CopyBuffer获取数据,不涉及句柄的创建和销毁。这样整个EA生命周期内,每个指标只创建一次,内存占用保持稳定。
// 正确示范:全局创建 + 析构释放
input string Symbols[] = {"EURUSD", "GBPUSD", "USDJPY"};
input ENUM_TIMEFRAMES TFs[] = {PERIOD_M15, PERIOD_H1, PERIOD_H4};

int m_ma_handles[][][];  // [symbol_index][tf_index][ma_period_index]
int m_rsi_handles[][];  // [symbol_index][tf_index]
int m_sym_count;
int m_tf_count;

int OnInit()
{
   m_sym_count = ArraySize(Symbols);
   m_tf_count  = ArraySize(TFs);

   // 二维数组:品种 × 周期
   ArrayResize(m_ma_handles, m_sym_count);
   ArrayResize(m_rsi_handles, m_sym_count);

   for(int s = 0; s < m_sym_count; s++)
   {
      ArrayResize(m_ma_handles[s], m_tf_count);
      ArrayResize(m_rsi_handles[s], m_tf_count);

      for(int t = 0; t < m_tf_count; t++)
      {
         // 创建MA句柄(20周期SMA)
         m_ma_handles[s][t] = iMA(Symbols[s], TFs[t], 20, 0, MODE_SMA, PRICE_CLOSE);
         if(m_ma_handles[s][t] == INVALID_HANDLE)
         {
            Print("创建MA句柄失败: ", Symbols[s], " ", EnumToString(TFs[t]));
            return INIT_FAILED;
         }

         // 创建RSI句柄(14周期)
         m_rsi_handles[s][t] = iRSI(Symbols[s], TFs[t], 14, PRICE_CLOSE);
         if(m_rsi_handles[s][t] == INVALID_HANDLE)
         {
            Print("创建RSI句柄失败: ", Symbols[s], " ", EnumToString(TFs[t]));
            return INIT_FAILED;
         }
      }
   }
   return INIT_SUCCEEDED;
}

void OnDeinit(const int reason)
{
   // 释放所有指标句柄
   for(int s = 0; s < m_sym_count; s++)
   {
      for(int t = 0; t < m_tf_count; t++)
      {
         if(m_ma_handles[s][t] != INVALID_HANDLE)
            IndicatorRelease(m_ma_handles[s][t]);
         if(m_rsi_handles[s][t] != INVALID_HANDLE)
            IndicatorRelease(m_rsi_handles[s][t]);
      }
   }
}
对于更复杂的场景——比如策略需要动态添加/删除品种、或者指标参数需要运行时调整——简单的全局数组就不够用了。这时候我们需要一个"智能句柄管理器",用引用计数的方式自动管理句柄的创建和释放,做到"按需创建、用完即放、重复利用"。在后面的完整代码骨架章节,我们会提供一个生产级的句柄管理器实现。
三、核心痛点二:多品种K线数据不对齐与"未来函数"陷阱
多品种EA开发中最隐蔽的陷阱,莫过于K线时间戳不对齐。你可能觉得不就是不同品种的K线吗,每根K线的开盘收盘时间应该是一样的吧?答案是:不一定。不同品种的交易时段不同、节假日不同、流动性不同,导致它们的K线时间戳可能存在微妙的差异。而这些差异,在回测中很容易引入"未来函数"——让你的策略在回测中表现惊人,实盘却一塌糊涂。
造成时间戳不对齐的原因主要有三个:
其一,交易时段差异。 Forex品种基本是24小时连续交易(周一到周五),但股指、期货、股票等品种有明确的开盘和收盘时间。比如德国DAX指数的交易时间是欧洲时段,美股标普500是美国时段,两者的K线时间戳虽然都是整点,但DAX在某些时段没有数据,而标普500在另一些时段没有数据。当你用M5周期做跨品种比较时,就会发现某些时间点一个有K线另一个没有。
第二,节假日差异。 不同国家的节假日不同。比如美国独立日(7月4日)美股休市,但欧洲市场正常交易;中国国庆节国内期货休市,但国际原油正常交易。即使都是Forex品种,在某些特殊日子(如圣诞节、元旦),不同经纪商的休市时间也可能不同。
第三,数据缺失与补录。 由于服务器故障、网络中断等原因,某些品种的历史数据可能存在缺漏。MT5终端在下载历史数据时,也可能因为数据源问题导致某些时间段的数据不完整。当你用CopyRates获取数据时,缺失的时间段会被跳过,数组中相邻两根K线的时间戳间隔可能大于周期长度。
那么,如何用时间戳精确匹配不同品种的K线呢?MQL5提供了一个非常有用的函数:iBarShift()。这个函数可以根据给定的时间戳,返回该时间戳对应K线索引。但需要注意它的第二个参数——是否精确匹配。
// 获取其他品种在"当前主品种K线时间"对应的K线索引
// symbol: 目标品种名称
// tf: 目标周期
// ref_time: 基准时间戳(主品种当前K线的开盘时间)
// 返回值: 目标品种中时间戳等于ref_time的K线索引,找不到返回-1
int GetAlignedBarShift(string symbol, ENUM_TIMEFRAMES tf, datetime ref_time)
{
   // exact=true: 精确匹配,找不到返回-1
   // exact=false: 返回最近的K线索引(可能引入未来函数!)
   int shift = iBarShift(symbol, tf, ref_time, true);
   return shift;
}
这里有一个非常关键的细节:iBarShift的第四个参数exact。如果设为false,当找不到精确匹配的时间戳时,函数会返回最近的那根K线的索引。这看起来很方便,但在回测中可能是致命的——因为"最近的"K线可能在基准时间的未来,相当于你用了还没发生的数据做决策。
下面是一个更安全的"最近邻"对齐算法。当精确匹配失败时,它会向历史方向查找最近一根已存在的K线,确保不会使用未来数据:
// 安全的时间戳对齐函数:向历史方向查找最近的K线
// 确保不会使用未来数据
int GetSafeBarShift(string symbol, ENUM_TIMEFRAMES tf, datetime ref_time)
{
   // 先尝试精确匹配
   int shift = iBarShift(symbol, tf, ref_time, true);
   if(shift >= 0) return shift;

   // 精确匹配失败,向历史方向查找(shift值更大 = 更久远)
   // 先获取离ref_time最近的K线(不管前后)
   int nearest = iBarShift(symbol, tf, ref_time, false);
   if(nearest < 0) return -1;

   // 检查这根K线的时间是否在ref_time之前或等于
   datetime bar_time = iTime(symbol, tf, nearest);
   if(bar_time <= ref_time)
   {
      // 在历史方向,安全使用
      return nearest;
   }
   else
   {
      // 在未来方向,回退一根(向历史方向)
      // 确保我们使用的是ref_time之前最近的一根
      if(nearest + 1 < iBars(symbol, tf))
         return nearest + 1;
      else
         return -1;
   }
}
四、架构升级:构建高效的"多周期数据缓存池"
解决了句柄泄漏和时间戳对齐的问题,接下来我们要面对的是MS/MT EA中最大的性能瓶颈:重复的数据获取。在单品种EA中,你可能感觉不到CopyRates的开销——毕竟数据就在本地,读取一次也就几毫秒。但在MS/MT架构下,如果有10个品种、4个周期,每次Tick都要调用40次CopyRates,开销就不再是可以忽略的了。特别是在回测中,策略测试器需要反复加载和计算数据,I/O开销会被放大数倍。
"数据缓存池"的设计思想很简单:把常用的数据从终端的缓冲区中"拿出来",放在EA自己管理的内存中。每次需要数据时,先检查缓存是否有效(是否是最新的),如果有效就直接从缓存读取;如果失效了(比如新K线来了),再从终端更新一次。这样可以把CopyRates的调用频率从"每次Tick"降低到"每根新K线",性能提升是数量级的。
一个完整的多周期数据缓存池,需要包含以下几个核心组件:
| 组件 | 功能 | 关键设计要点 |
|---|---|---|
| 数据结构 | 存储OHLCV等K线数据 | 使用MqlRates结构体数组,按品种+周期二维组织 |
| 时间戳标记 | 记录缓存的最新K线时间 | 用最新K线开盘时间判断缓存是否需要更新 |
| 更新机制 | 检测新K线并刷新缓存 | 只更新有新K线的品种和周期,避免全量刷新 |
| 容量控制 | 限制缓存的K线数量 | 根据策略实际需要设置缓存深度,如200根或500根 |
| 索引映射 | 快速定位指定时间的K线 | 缓存数组与终端数组方向一致(0为最新),直接索引访问 |
下面是一个简化版的数据缓存池实现。它的核心思路是:用一个二维数组缓存各品种各周期的K线数据,在每次OnTick开始时检查是否有新K线,如果有就只更新那一根(或几根),而不是重新获取全部数据。
// 数据缓存池类(简化版)
class CRatesCachePool
{
private:
   string          m_symbols[];
   ENUM_TIMEFRAMES m_timeframes[];
   MqlRates        m_rates[][][];    // [symbol_idx][tf_idx][bar_idx]
   datetime        m_last_update[];  // [symbol_idx * tf_count + tf_idx]
   int             m_sym_count;
   int             m_tf_count;
   int             m_cache_depth;    // 缓存深度(K线根数)

public:
   CRatesCachePool() : m_sym_count(0), m_tf_count(0), m_cache_depth(500) {}
   ~CRatesCachePool() {}

   // 初始化缓存池
   bool Init(string symbols[], ENUM_TIMEFRAMES timeframes[], int depth = 500)
   {
      m_sym_count   = ArraySize(symbols);
      m_tf_count    = ArraySize(timeframes);
      m_cache_depth = depth;

      // 复制品种和周期配置
      ArrayResize(m_symbols, m_sym_count);
      ArrayResize(m_timeframes, m_tf_count);
      ArrayCopy(m_symbols, symbols);
      ArrayCopy(m_timeframes, timeframes);

      // 三维数组:品种 × 周期 × K线
      ArrayResize(m_rates, m_sym_count);
      for(int s = 0; s < m_sym_count; s++)
      {
         ArrayResize(m_rates[s], m_tf_count);
         for(int t = 0; t < m_tf_count; t++)
         {
            ArrayResize(m_rates[s][t], m_cache_depth);
         }
      }

      // 初始化时间标记
      ArrayResize(m_last_update, m_sym_count * m_tf_count);
      ArrayInitialize(m_last_update, 0);

      // 首次全量加载
      return FullRefresh();
   }

   // 全量刷新所有缓存
   bool FullRefresh()
   {
      bool success = true;
      for(int s = 0; s < m_sym_count; s++)
      {
         for(int t = 0; t < m_tf_count; t++)
         {
            int copied = CopyRates(m_symbols[s], m_timeframes[t], 0, m_cache_depth, m_rates[s][t]);
            if(copied <= 0)
            {
               Print("缓存池全量刷新失败: ", m_symbols[s], " ", EnumToString(m_timeframes[t]));
               success = false;
            }
            else
            {
               m_last_update[s * m_tf_count + t] = m_rates[s][t][0].time;
            }
         }
      }
      return success;
   }

   // 增量更新:只更新有新K线的品种/周期
   void TickUpdate()
   {
      for(int s = 0; s < m_sym_count; s++)
      {
         for(int t = 0; t < m_tf_count; t++)
         {
            // 检查当前最新K线时间是否变化
            datetime current_time = iTime(m_symbols[s], m_timeframes[t], 0);
            int idx = s * m_tf_count + t;

            if(current_time != m_last_update[idx])
            {
               // 有新K线,只更新前几根(通常只需更新1-2根)
               // 因为新K线出现时,最旧的那根被挤出缓存
               int copied = CopyRates(m_symbols[s], m_timeframes[t], 0, m_cache_depth, m_rates[s][t]);
               if(copied > 0)
               {
                  m_last_update[idx] = m_rates[s][t][0].time;
               }
            }
         }
      }
   }

   // 获取指定品种和周期的K线数据(只读访问)
   bool GetRates(int sym_idx, int tf_idx, MqlRates &out_rates[]) const
   {
      if(sym_idx < 0 || sym_idx >= m_sym_count) return false;
      if(tf_idx  < 0 || tf_idx  >= m_tf_count)  return false;

      int count = ArrayCopy(out_rates, m_rates[sym_idx][tf_idx]);
      return (count > 0);
   }

   // 获取单根K线(最常用的快速访问)
   bool GetSingleRate(int sym_idx, int tf_idx, int shift, MqlRates &rate) const
   {
      if(sym_idx < 0 || sym_idx >= m_sym_count) return false;
      if(tf_idx  < 0 || tf_idx  >= m_tf_count)  return false;
      if(shift   < 0 || shift   >= m_cache_depth) return false;

      rate = m_rates[sym_idx][tf_idx][shift];
      return true;
   }
};
上面的简化版实现用了"全量复制"的更新方式——每次更新都重新获取全部缓存深度的K线。对于500根的缓存深度来说,这虽然比每次Tick都获取好很多,但仍然有优化空间。更极致的优化是做"增量更新"——检测到新K线时,只把最新的1-2根K线插入缓存数组,其余数据通过数组移位来实现。这样每次更新只需要CopyRates 1-2根,I/O开销降到最低。
缓存池设计中还有一个容易被忽略的问题:缓存深度的选择。缓存越深,能支持的策略指标越复杂(比如需要200期均线就至少需要200根K线),但内存占用也越大。对于MS/MT EA来说,假设10个品种 × 4个周期 × 500根K线,每根MqlRates结构体大约占用56字节(datetime 8 + double×6个48 = 56),总内存占用是 10 × 4 × 500 × 56 = 1.12MB。这个量其实很小,所以不必过度担心内存占用,设置500-1000根的缓存深度是合理的。真正占内存的是指标句柄和指标buffer,而不是K线数据本身。
五、并发与性能:利用事件驱动与异步处理优化回测
解决了数据缓存的问题,我们再往上走一层,看看如何从架构层面提升MS/MT EA的执行效率。MT5本身是一个事件驱动的平台——OnTick、OnTimer、OnBookEvent、OnChartEvent——每个事件对应不同的触发时机。很多开发者写MS/MT EA的时候,习惯把所有逻辑都塞到OnTick里,包括数据获取、指标计算、信号判断、订单管理。这样写的问题是:OnTick被触发得太频繁了,尤其是在行情波动剧烈的时候,一秒钟可能有几十上百个Tick,每个Tick都跑一遍完整逻辑,CPU消耗巨大。
事件驱动架构的核心思想是:不同的事情,在不同的时机做。具体来说:
| 事件函数 | 触发时机 | 适合做的事 | 不适合做的事 |
|---|---|---|---|
| OnTick | 每次价格变动 | 核心交易逻辑、入场出场判断、紧急风控 | 数据预加载、非紧急的计算 |
| OnTimer | 按固定时间间隔 | 数据预加载、非实时计算、状态同步 | 毫秒级响应的交易逻辑 |
| OnBookEvent | 深度报价变化 | 做市商策略、订单簿分析、流动性检测 | 普通趋势策略(浪费资源) |
| OnCalculate | 指标计算 | 自定义指标的批量计算 | 交易逻辑、订单操作 |
对于MS/MT EA来说,最有价值的优化手段是把数据预加载从OnTick移到OnTimer。原理很简单:多品种数据的获取和处理是耗时操作,但它不需要每个Tick都做——K线数据每秒最多变一次(Tick价格虽然一直变,但K线数据只在K线收盘时才增加一根)。所以我们可以设置一个定时器,比如每秒触发一次,在OnTimer中统一更新所有品种的缓存数据。OnTick里只负责读缓存和做交易决策,这样OnTick的执行时间被大幅压缩,Tick响应速度更快。
// 事件驱动架构示例

CRatesCachePool g_cache_pool;

int OnInit()
{
   // 初始化缓存池...
   string syms[] = {"EURUSD", "GBPUSD", "USDJPY"};
   ENUM_TIMEFRAMES tfs[] = {PERIOD_M15, PERIOD_H1, PERIOD_H4};
   g_cache_pool.Init(syms, tfs, 500);

   // 创建定时器,每秒触发一次
   // 用于后台数据预加载
   EventSetTimer(1);

   return INIT_SUCCEEDED;
}

void OnDeinit(const int reason)
{
   EventKillTimer();
}

// OnTimer:负责数据更新(异步预加载)
void OnTimer()
{
   // 更新所有品种的缓存数据
   g_cache_pool.TickUpdate();

   // 还可以在这里做一些非实时的计算
   // 比如:趋势强度评估、市场波动率统计等
   CalculateMarketRegime();
}

// OnTick:只负责核心交易逻辑(读缓存 + 决策 + 下单)
void OnTick()
{
   // 注意:这里不再调用CopyRates
   // 所有数据都从缓存池中读取

   for(int s = 0; s < SYM_COUNT; s++)
   {
      // 从缓存读取M15的最新K线
      MqlRates m15_rate;
      if(!g_cache_pool.GetSingleRate(s, 0, 1, m15_rate)) continue;

      // 从缓存读取H1的最新数据
      MqlRates h1_rate;
      if(!g_cache_pool.GetSingleRate(s, 1, 1, h1_rate)) continue;

      // 基于缓存数据做交易决策
      if(CheckEntryCondition(s, m15_rate, h1_rate))
      {
         ExecuteTrade(s, OP_BUY);
      }
   }
}
还有一个容易被忽视的优化点:多品种的"批量处理" vs "逐个处理"。很多人的OnTick里是对每个品种依次做"获取数据→计算指标→判断信号→下单"的完整流程。这样写逻辑清晰,但效率不高——因为不同品种的数据获取和指标计算可以"批量"进行,利用CPU的缓存局部性提升效率。更优的做法是分成三个阶段:第1阶段批量更新所有品种的数据,第2阶段批量计算所有品种的指标,第3阶段批量判断所有品种的交易信号。这样每个阶段都在做同类型的操作,CPU缓存命中率更高,执行效率更好。
六、内存监控实战:在EA内部嵌入性能监控面板
优化的前提是量化。如果你不知道当前EA的内存占用是多少、CPU使用率有多高、句柄数量有多少,就不知道优化有没有效果、还有多少优化空间。所以,一个专业的MS/MT EA必须内置性能监控功能,让开发者能够实时看到EA的运行状态,快速定位性能瓶颈。
TerminalInfoInteger() 可以获取终端的内存使用量、CPU占用率等信息;GetMicrosecondCount() 可以精确测量代码段的执行时间;MQLInfoInteger() 可以获取MQL5程序本身的信息。这些函数是实现性能监控的基础。
一个实用的性能监控面板,至少应该包含以下几项指标:
- 内存占用:MT5终端当前使用的物理内存大小,用于检测内存泄漏趋势
- 句柄数量:EA当前持有的指标句柄总数,句柄泄漏时这个数会持续增长
- Tick执行时间:每次OnTick的执行耗时(微秒级),反映策略逻辑的计算复杂度
- 数据获取耗时:CopyRates / CopyBuffer 的耗时,反映I/O瓶颈
- 新K线检测:当前各品种各周期是否检测到新K线,验证缓存更新机制
- 订单/持仓数量:当前的持仓单数和挂单数,风控相关的基础指标
下面是一个轻量级的性能监控器实现。它使用MQL5的对象绘图功能,在图表左上角实时显示各项性能指标:
// 性能监控器类
class CPerformanceMonitor
{
private:
   string   m_prefix;          // 对象名称前缀
   int      m_indicator_count; // 指标句柄数量
   int      m_last_tick_us;    // 上次Tick耗时(微秒)
   int      m_last_data_us;    // 上次数据更新耗时
   long     m_last_mem_mb;     // 上次内存占用(MB)
   datetime m_last_check_time; // 上次检查时间

public:
   CPerformanceMonitor() : m_indicator_count(0), m_last_tick_us(0),
                           m_last_data_us(0), m_last_mem_mb(0) {}
   ~CPerformanceMonitor() { ClearObjects(); }

   void Init(string prefix = "perf_mon_")
   {
      m_prefix = prefix;
      CreateLabelObjects();
   }

   // Tick开始时调用,记录起始时间
   ulong TickStart()
   {
      return GetMicrosecondCount();
   }

   // Tick结束时调用,计算耗时并更新显示
   void TickEnd(ulong start_time)
   {
      m_last_tick_us = (int)(GetMicrosecondCount() - start_time);
      UpdateDisplay();
   }

   // 记录数据获取耗时
   void SetDataUpdateTime(int us) { m_last_data_us = us; }

   // 设置当前指标句柄数量
   void SetIndicatorCount(int count) { m_indicator_count = count; }

private:
   void CreateLabelObjects()
   {
      // 创建7个标签对象显示各项指标
      // (实际代码中需要用ObjectCreate创建每个标签)
   }

   void UpdateDisplay()
   {
      // 每秒更新一次显示,避免频繁重绘
      datetime now = TimeCurrent();
      if(now == m_last_check_time) return;
      m_last_check_time = now;

      // 获取终端内存占用
      long mem_bytes = TerminalInfoInteger(TERMINAL_MEMORY_USED);
      m_last_mem_mb  = mem_bytes / (1024 * 1024);

      // 更新各个标签的文本
      // 内存占用、句柄数、Tick耗时、数据耗时等
   }

   void ClearObjects()
   {
      // 清理所有创建的图表对象
   }
};
除了图表上的实时监控,日志记录同样重要。建议在EA中加入"性能日志"功能——每隔一段时间(比如每小时或每天),把当前的内存占用、句柄数量、平均Tick耗时等数据写入日志文件。回测完成后,可以用Python分析这些日志数据,画出内存增长曲线,直观地判断是否存在内存泄漏。如果内存曲线是持续上升的(斜率为正),说明存在泄漏;如果内存曲线在某个水平上下波动,说明内存管理良好。
七、完整代码骨架:一个生产级的MS/MT EA基础框架
前面我们分别讲了句柄管理、时间戳对齐、数据缓存池、事件驱动架构和性能监控。现在,我们把这些组件整合起来,构建一个生产级的MS/MT EA基础框架。这个框架可以作为你开发多品种EA的起点——你只需要在信号判断和交易执行的部分填入自己的策略逻辑,底层的数据管理、内存管理、性能监控都已经帮你搭好了。
框架的整体架构分为三层:
- 数据层:数据缓存池 + 句柄管理器,负责所有数据的获取和缓存,向上提供统一的数据访问接口
- 计算层:信号计算器 + 风控模块,基于数据层提供的数据进行策略计算和风险评估
- 执行层:订单管理器 + 事件调度器,负责交易执行和事件响应
这样分层的好处是各层职责清晰、互相解耦。数据层不关心策略是什么,只管提供数据;计算层不关心数据怎么来的,只管基于数据做决策;执行层不关心决策怎么来的,只管把订单发出去。当你需要修改某个部分时(比如换一个数据源、或者改一个指标),只需要改对应的层,不会影响其他部分。
//+------------------------------------------------------------------+
//|                                          MS_MT_Framework.mqh     |
//|                        多品种多周期EA基础框架 v1.0                |
//+------------------------------------------------------------------+
#property copyright "eafxtech.com"
#property link      "https://www.eafxtech.com"
#property version   "1.00"
#property strict

// --- 配置参数 ---
input string InpSymbols[]    = {"EURUSD", "GBPUSD", "USDJPY", "AUDUSD", "USDCAD"};
input ENUM_TIMEFRAMES InpTFs[] = {PERIOD_M15, PERIOD_H1, PERIOD_H4, PERIOD_D1};
input int    InpCacheDepth   = 500;           // 缓存深度
input int    InpTimerInterval = 1;            // 定时器间隔(秒)
input double InpRiskPerTrade = 0.01;          // 单笔风险比例
input bool   InpEnableMonitor = true;         // 启用性能监控

// --- 全局管理器实例 ---
CRatesCachePool     g_rates_cache;   // 数据缓存池
CHandleManager      g_handle_mgr;    // 句柄管理器
COrderManager       g_order_mgr;     // 订单管理器
CPerformanceMonitor g_perf_mon;      // 性能监控器
CSignalEngine       g_signal_engine; // 信号引擎

int g_sym_count;
int g_tf_count;

//+------------------------------------------------------------------+
//| 初始化函数                                                       |
//+------------------------------------------------------------------+
int OnInit()
{
   g_sym_count = ArraySize(InpSymbols);
   g_tf_count  = ArraySize(InpTFs);

   if(g_sym_count == 0 || g_tf_count == 0)
   {
      Print("错误:品种或周期配置为空");
      return INIT_PARAMETERS_INCORRECT;
   }

   // 1. 初始化数据缓存池
   if(!g_rates_cache.Init(InpSymbols, InpTFs, InpCacheDepth))
   {
      Print("数据缓存池初始化失败");
      return INIT_FAILED;
   }

   // 2. 初始化句柄管理器(根据需要创建指标句柄)
   if(!g_handle_mgr.Init(g_sym_count, g_tf_count))
   {
      Print("句柄管理器初始化失败");
      return INIT_FAILED;
   }

   // 3. 初始化订单管理器
   g_order_mgr.Init(InpRiskPerTrade);

   // 4. 初始化信号引擎
   g_signal_engine.Init(g_sym_count, g_tf_count);

   // 5. 初始化性能监控
   if(InpEnableMonitor)
   {
      g_perf_mon.Init("msmt_perf_");
      g_perf_mon.SetIndicatorCount(g_handle_mgr.GetTotalHandleCount());
   }

   // 6. 启动定时器(用于后台数据更新)
   EventSetTimer(InpTimerInterval);

   Print("MS/MT框架初始化完成: ", g_sym_count, " 个品种, ", g_tf_count, " 个周期");
   return INIT_SUCCEEDED;
}

//+------------------------------------------------------------------+
//| 析构函数                                                         |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
{
   EventKillTimer();

   // 按顺序清理资源
   g_order_mgr.Cleanup();
   g_handle_mgr.Cleanup();     // 释放所有指标句柄
   g_rates_cache.Cleanup();

   Print("MS/MT框架已清理,退出原因: ", reason);
}

//+------------------------------------------------------------------+
//| 定时器事件:后台数据更新 + 非实时计算                             |
//+------------------------------------------------------------------+
void OnTimer()
{
   ulong start = GetMicrosecondCount();

   // 更新数据缓存
   g_rates_cache.TickUpdate();

   // 更新指标缓冲区(如果使用了指标句柄)
   g_handle_mgr.RefreshBuffers();

   int elapsed = (int)(GetMicrosecondCount() - start);

   if(InpEnableMonitor)
      g_perf_mon.SetDataUpdateTime(elapsed);
}

//+------------------------------------------------------------------+
//| Tick事件:核心交易逻辑                                           |
//+------------------------------------------------------------------+
void OnTick()
{
   ulong tick_start = g_perf_mon.TickStart();

   // 遍历所有品种,检查交易信号
   for(int s = 0; s < g_sym_count; s++)
   {
      // 跳过不可交易的品种
      if(!SymbolSelect(InpSymbols[s], false)) continue;
      if(SymbolInfoInteger(InpSymbols[s], SYMBOL_TRADE_MODE) == SYMBOL_TRADE_MODE_DISABLED) continue;

      // 从缓存池获取关键周期的数据
      MqlRates m15_rate, h1_rate, h4_rate;
      if(!g_rates_cache.GetSingleRate(s, 0, 1, m15_rate)) continue;
      if(!g_rates_cache.GetSingleRate(s, 1, 1, h1_rate))  continue;
      if(!g_rates_cache.GetSingleRate(s, 2, 1, h4_rate))  continue;

      // 交给信号引擎判断
      ENUM_ORDER_TYPE signal = g_signal_engine.CheckSignal(
         s, m15_rate, h1_rate, h4_rate, g_handle_mgr);

      // 有信号则交给订单管理器执行
      if(signal != ORDER_TYPE_CLOSE_BY)
      {
         g_order_mgr.ExecuteSignal(InpSymbols[s], signal, m15_rate.close);
      }
   }

   // 监控更新
   if(InpEnableMonitor)
      g_perf_mon.TickEnd(tick_start);
}

//+------------------------------------------------------------------+
//| 交易事件:订单状态变化处理                                       |
//+------------------------------------------------------------------+
void OnTradeTransaction(const MqlTradeTransaction &trans,
                        const MqlTradeRequest &request,
                        const MqlTradeResult &result)
{
   g_order_mgr.OnTransaction(trans, request, result);
}
//+------------------------------------------------------------------+
这个框架的核心价值在于"把复杂的底层问题封装起来,让你只关注策略本身"。当你要开发一个新的MS/MT EA时,不需要重新写一遍数据缓存、句柄管理、时间戳对齐这些基础组件,只需要:
- 在输入参数中配置需要的品种和周期
- 在信号引擎类(CSignalEngine)中实现你的策略逻辑
- 在订单管理器类(COrderManager)中调整风控参数
其余的事情——数据怎么获取、句柄怎么管理、内存怎么监控、定时器怎么调度——框架都帮你处理好了。这样不仅开发效率高,而且代码质量有保障——框架的底层组件经过了多个项目的验证和打磨,稳定性远高于每次从零写起。
八、总结与下一步:从单线程到分布式测试的演进
到这里,我们系统地拆解了MS/MT EA开发中的六大核心痛点:指标句柄泄漏、K线时间戳不对齐、重复数据获取、并发效率低下、内存监控缺失、架构设计混乱。针对每一个痛点,我们都深入了底层原理,给出了具体的代码解决方案,最后提供了一套完整的MS/MT EA基础框架。
回顾一下全链路调优的核心思想:从底层到上层,逐层优化,先量化再优化。先解决句柄泄漏这种"正确性"问题(泄漏了就是bug),再解决数据缓存这种"效率"问题(不缓存也能跑但慢),最后再做架构层面的事件驱动和并发优化。顺序不能搞反——如果连内存泄漏都没解决,谈并发优化就是空中楼阁。
性能优化是一个持续的过程,没有"最终版本"。随着策略复杂度的增加、品种数量的扩展、数据周期的细化,新的性能瓶颈会不断出现。但只要你掌握了本文介绍的方法论——量化问题、定位瓶颈、逐层优化、持续监控——就能从容应对各种性能挑战。
最后,送给所有EA开发者一句话:好的EA不是写出来的,是调出来的。 一个优秀的MS/MT EA,背后是无数次的性能剖析、内存排查、参数调优。不要满足于"能跑",要追求"跑得快、跑得稳、跑得久"。希望本文的内容能帮你在这条路上走得更远。
扫码关注,获取更多EA开发干货

微信公众号

视频号