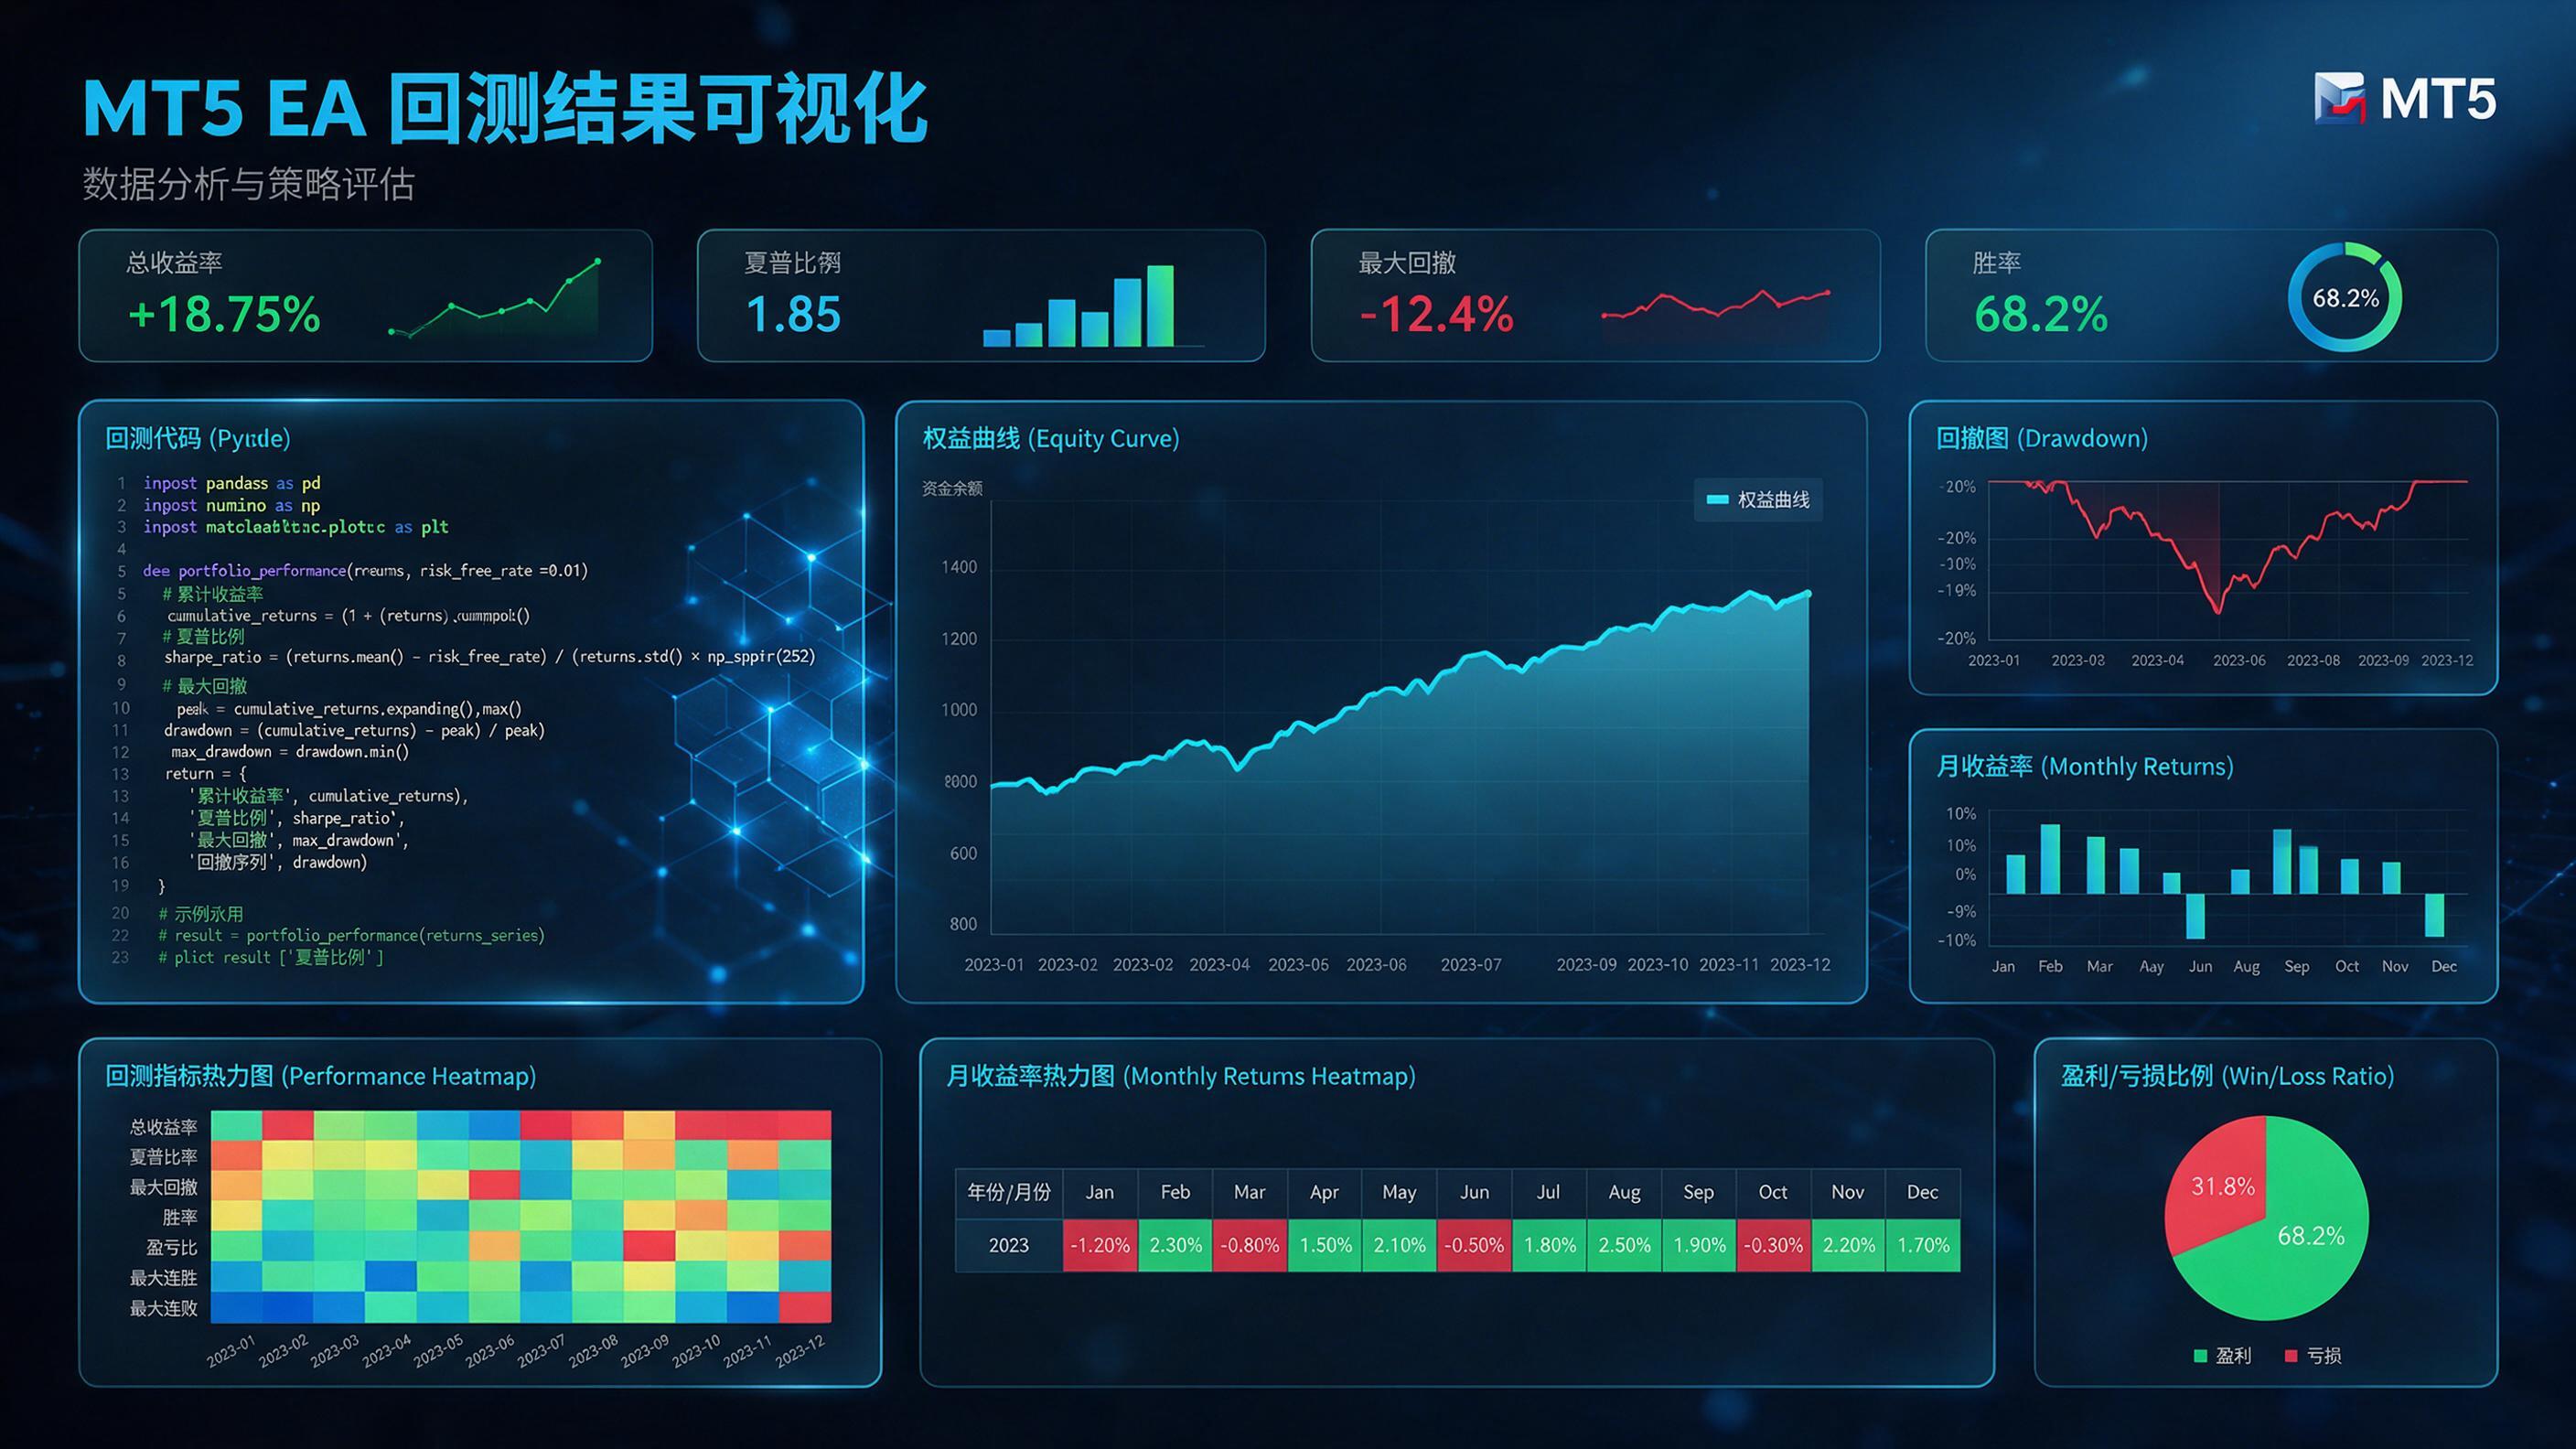
MT5 EA回测可视化实战:用Python打造专业级绩效分析图表
从资金曲线图、回撤图到热力图、蒙特卡洛分布,让你的EA分析报告提升一个档次
一、引言:为什么MT5自带的回测报告不够用?
做过EA回测的朋友应该都有过这样的经历:跑完一个策略,点开Strategy Tester的Report标签页,看着满屏密密麻麻的数字和灰蓝色的默认图表,想从里面找出关键信息得翻半天。更尴尬的是,当你要把回测结果发给客户或者投资人看的时候,总觉得MT5自带的报告"拿不出手"——不够专业、不够清晰、不够有说服力。
这不是你的错觉。MetaTrader 5的Strategy Tester作为一个回测引擎是合格的,但它的报告模块确实存在不少短板。在eafxtech的EA定制项目中,我们经常收到客户这样的反馈:"回测数据有了,但能不能给我一份更专业的分析报告?"这恰恰说明了市场对高质量回测可视化的强烈需求。
Python作为数据科学的主流工具,拥有pandas、matplotlib、seaborn、plotly等一整套成熟的可视化生态。用Python来做EA回测可视化,你可以获得四个核心优势:第一是专业性,做出媲美量化机构的绩效分析报告;第二是灵活性,想画什么图、想怎么配色,完全由你说了算;第三是可定制性,可以根据不同客户的需求定制不同风格的报告;第四是可自动化,一次写好脚本,以后每次跑完回测一键出图,效率提升十倍以上。
本文将带你从零开始,系统学习如何用Python对MT5回测结果进行专业级可视化。我们会从环境搭建讲起,讲解数据获取的三种方式,然后逐层深入——从基础的资金曲线和回撤图,到进阶的热力图和蒙特卡洛模拟,再到交易散点图和分布图。最后,我们会把所有图表整合起来,打造一个一键生成完整分析报告的脚本。读完本文,你将拥有一套完整的EA回测可视化工具链。
二、环境准备:Python + pandas + matplotlib + plotly环境搭建
工欲善其事,必先利其器。在开始画图之前,我们先把环境搭好。本文涉及的Python库有四个核心:pandas用于数据处理,matplotlib用于基础绘图,seaborn用于统计图表美化,plotly用于交互式图表。这四个库是金融数据分析的黄金组合,各有所长。
2.1 安装方法
如果你已经安装了Anaconda,那么pandas和matplotlib通常已经自带了,只需要额外安装seaborn和plotly。如果你用的是纯净的Python环境,可以通过pip一键安装所有依赖:
# 一行命令安装所有依赖
pip install pandas matplotlib seaborn plotly numpy openpyxl

# 验证安装
python -c "import pandas; import matplotlib; import seaborn; import plotly; print('All libraries installed successfully')"
2.2 中文显示问题
使用matplotlib画图的朋友,十有八九都遇到过中文显示成方块的问题。这是因为matplotlib的默认字体不支持中文字符。解决方法很简单,在代码开头加上以下配置:
import matplotlib.pyplot as plt
from matplotlib import rcParams

# 设置中文字体(根据你的系统选择)
# Windows系统
rcParams['font.sans-serif'] = ['Microsoft YaHei']
# Mac系统
# rcParams['font.sans-serif'] = ['Arial Unicode MS', 'PingFang SC']

# 解决负号显示问题
rcParams['axes.unicode_minus'] = False

# 设置全局绘图风格(可选,提升美观度)
plt.style.use('seaborn-v0_8-whitegrid')
三、数据获取:从MT5导出回测报告的3种方式
画图的前提是有数据。MT5的回测数据有三种主要的导出方式,各有优缺点,适用于不同的场景。了解这三种方式,你就能根据自己的需求选择最合适的数据来源。
3.1 方式一:Strategy Tester直接导出CSV
这是最简单直接的方式,适合初学者和快速分析场景。操作步骤如下:
- 在MT5中打开Strategy Tester,选择你要分析的EA和参数
- 运行回测,等待回测完成
- 切换到"交易历史"(Trades)标签页
- 右键点击表格,选择"导出"→"CSV"
- 选择保存路径和文件名,点击保存
这种方式的优点是操作简单、字段清晰、CSV格式便于读取。缺点是只能导出逐笔交易数据,缺少账户净值曲线等汇总数据,需要自己计算衍生指标。对于大多数回测分析场景来说,交易级别的CSV数据已经足够了。
3.2 方式二:HTML报告解析
如果你需要更完整的回测数据(包括净值曲线、持仓明细、所有绩效指标等),可以解析MT5生成的HTML报告。在Strategy Tester的Report标签页中,右键选择"保存为报告",就可以导出HTML格式的完整报告。
解析HTML报告需要用到BeautifulSoup库。以下是一个简单的示例:
from bs4 import BeautifulSoup
import pandas as pd

def parse_mt5_html_report(html_path):
    """解析MT5 HTML回测报告,提取交易表格和汇总指标"""
    with open(html_path, 'r', encoding='utf-16') as f:
        soup = BeautifulSoup(f.read(), 'html.parser')

    # 提取交易历史表格
    trade_tables = soup.find_all('table')
    # ... 根据table结构解析交易数据

    # 提取汇总指标
    summary = {}
    # ... 解析净利润、胜率、最大回撤等指标

    return summary
HTML解析的优点是信息最全,包含了MT5计算好的所有绩效指标和图表数据。缺点是解析比较复杂,不同版本的MT5 HTML结构可能不一样,需要做兼容性处理。
3.3 方式三:Tester日志文件解析
第三种方式是直接解析MT5的Tester日志文件。日志文件中包含了回测过程中的每一笔交易、每一个事件的详细记录。这种方式适合极端情况——比如你需要tick级别的精确数据,或者CSV导出不可用的时候。
日志文件通常位于MT5数据目录的Tester文件夹下,文件名形如"20261001.log"。解析日志需要使用正则表达式,相对比较繁琐。一般情况下不推荐作为首选方式,但作为备选方案,了解一下是有好处的。
四、基础图表1:资金曲线图
资金曲线图是回测分析中最基础也最重要的图表,没有之一。一张好的资金曲线图,可以让读者一眼看清策略的整体表现——赚了多少钱、走势是否平稳、有没有大的回撤。我们从最简单的单曲线开始,逐步升级到专业级的多元素资金曲线图。
4.1 数据读取与清洗
在画图之前,我们需要先把MT5导出的CSV数据读进来,并做必要的清洗和计算。不同版本的MT5导出的CSV字段名可能略有差异,所以读取函数需要做一定的兼容性处理。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import rcParams

# 中文字体配置
rcParams['font.sans-serif'] = ['Microsoft YaHei']
rcParams['axes.unicode_minus'] = False

def load_mt5_trades_csv(file_path, initial_balance=10000):
    """
    读取MT5导出的交易历史CSV并计算衍生指标
    返回包含逐笔盈亏和累计净值的DataFrame
    """
    # 尝试不同编码读取
    for enc in ['utf-8', 'gbk', 'utf-16']:
        try:
            df = pd.read_csv(file_path, encoding=enc, sep=None, engine='python')
            break
        except:
            continue

    # 统一列名(兼容中英文版本)
    column_mapping = {
        '时间': 'Time', '交易': 'Deal',
        '品种': 'Symbol', '类型': 'Type',
        '方向': 'Direction', '成交量': 'Volume',
        '价格': 'Price', '手续费': 'Commission',
        '获利': 'Profit', '余额': 'Balance',
    }
    for cn, en in column_mapping.items():
        if cn in df.columns:
            df.rename(columns={cn: en}, inplace=True)

    # 处理时间列
    df['Time'] = pd.to_datetime(df['Time'], errors='coerce')
    df = df.dropna(subset=['Time'])
    df = df.sort_values('Time').reset_index(drop=True)

    # 确保Profit列为数值类型
    df['Profit'] = pd.to_numeric(df['Profit'], errors='coerce').fillna(0)

    # 计算累计净值
    df['Cumulative_Profit'] = df['Profit'].cumsum()
    df['Equity'] = initial_balance + df['Cumulative_Profit']
    df['Return'] = df['Equity'] / initial_balance - 1

    # 计算回撤
    df['Peak'] = df['Equity'].cummax()
    df['Drawdown'] = df['Equity'] - df['Peak']
    df['Drawdown_Pct'] = df['Drawdown'] / df['Peak'] * 100

    return df
4.2 专业级资金曲线图绘制
一个专业的资金曲线图,通常包含以下元素:净值曲线(显示整体趋势)、余额曲线(如果有持仓的话)、关键点位标注(最大回撤点、历史新高点)、以及可选的基准对比曲线。下面的代码实现了一个功能完整的资金曲线图:
def plot_equity_curve(df, title='资金曲线图', benchmark_curve=None):
    """
    绘制专业级资金曲线图
    包含:净值曲线、最大回撤标注、新高点标注、可选基准曲线
    """
    fig, ax = plt.subplots(figsize=(14, 6), dpi=150)

    # 主色调
    color_equity = '#1f77b4'
    color_benchmark = '#ff7f0e'
    color_dd = '#d62728'
    color_high = '#2ca02c'

    # 绘制净值曲线
    ax.plot(df['Time'], df['Equity'],
            color=color_equity, linewidth=1.5, label='账户净值', zorder=3)

    # 填充曲线下方区域(渐变效果)
    ax.fill_between(df['Time'], df['Equity'].iloc[0], df['Equity'],
                    alpha=0.15, color=color_equity, zorder=2)

    # 绘制基准曲线(如果有)
    if benchmark_curve is not None:
        ax.plot(df['Time'], benchmark_curve,
                color=color_benchmark, linewidth=1.2,
                linestyle='--', label='基准指数', alpha=0.7)

    # 标注最大回撤点
    max_dd_idx = df['Drawdown_Pct'].idxmin()
    max_dd_val = df.loc[max_dd_idx, 'Drawdown_Pct']
    max_dd_time = df.loc[max_dd_idx, 'Time']
    max_dd_equity = df.loc[max_dd_idx, 'Equity']

    ax.scatter(max_dd_time, max_dd_equity, color=color_dd, s=50, zorder=5, label='最大回撤点')
    ax.annotate(f'最大回撤: {max_dd_val:.2f}%',
                xy=(max_dd_time, max_dd_equity),
                xytext=(20, -30), textcoords='offset points',
                fontsize=9, color=color_dd,
                arrowprops=dict(arrowstyle='->', color=color_dd))

    # 标注最终收益
    final_return = (df['Equity'].iloc[-1] / df['Equity'].iloc[0] - 1) * 100
    ax.scatter(df['Time'].iloc[-1], df['Equity'].iloc[-1],
               color=color_high, s=50, zorder=5)
    ax.annotate(f'最终收益: {final_return:.2f}%',
                xy=(df['Time'].iloc[-1], df['Equity'].iloc[-1]),
                xytext=(-80, 15), textcoords='offset points',
                fontsize=9, color=color_high,
                arrowprops=dict(arrowstyle='->', color=color_high))

    # 图表美化
    ax.set_title(title, fontsize=14, fontweight='bold', pad=15)
    ax.set_xlabel('时间', fontsize=11)
    ax.set_ylabel('账户净值 ($)', fontsize=11)
    ax.legend(loc='upper left', fontsize=10, framealpha=0.9)
    ax.grid(True, alpha=0.3, linestyle='--')
    ax.spines['top'].set_visible(False)
    ax.spines['right'].set_visible(False)

    # 自动调整日期显示
    fig.autofmt_xdate()
    plt.tight_layout()

    return fig, ax
五、基础图表2:回撤分析
如果说资金曲线反映的是策略"赚了多少钱",那么回撤图反映的就是策略"亏了多少钱、亏了多久"。回撤是风险的直观体现,也是投资者最关心的指标之一。很多人看资金曲线只关注最终收益,却忽视了过程中的痛苦程度——一个收益20%但回撤5%的策略,远比一个收益30%但回撤30%的策略更有价值。
5.1 水下回撤图(Underwater Plot)
水下回撤图是展示回撤的标准方式。它的纵轴是回撤百分比(通常是负数),横轴是时间。当曲线处于水下(0以下)时,表示账户正在经历回撤。曲线越低,回撤越深;曲线在水下待的时间越长,回撤持续时间越久。
下面的代码实现了资金曲线+回撤图的上下双子图布局,这是专业绩效报告的标准呈现方式:
def plot_equity_with_drawdown(df, title='资金曲线与回撤分析'):
    """
    绘制资金曲线 + 回撤水下图(上下双子图布局)
    上图:资金曲线  下图:回撤水下图
    """
    fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(14, 8),
                                    sharex=True, dpi=150,
                                    gridspec_kw={'height_ratios': [3, 1]})

    # 上图:资金曲线
    ax1.plot(df['Time'], df['Equity'],
             color='#1f77b4', linewidth=1.5, label='账户净值')
    ax1.plot(df['Time'], df['Peak'],
             color='#2ca02c', linewidth=1, linestyle='--',
             label='历史峰值', alpha=0.7)
    ax1.fill_between(df['Time'], df['Equity'].iloc[0],
                     df['Equity'], alpha=0.15, color='#1f77b4')

    ax1.set_title(title, fontsize=14, fontweight='bold', pad=15)
    ax1.set_ylabel('账户净值 ($)', fontsize=11)
    ax1.legend(loc='upper left', fontsize=10)
    ax1.grid(True, alpha=0.3, linestyle='--')
    ax1.spines['top'].set_visible(False)
    ax1.spines['right'].set_visible(False)

    # 下图:回撤水下图
    ax2.fill_between(df['Time'], df['Drawdown_Pct'], 0,
                     color='#d62728', alpha=0.3)
    ax2.plot(df['Time'], df['Drawdown_Pct'],
             color='#d62728', linewidth=1)

    # 标注最大回撤
    max_dd_idx = df['Drawdown_Pct'].idxmin()
    max_dd_val = df.loc[max_dd_idx, 'Drawdown_Pct']
    ax2.scatter(df.loc[max_dd_idx, 'Time'], max_dd_val,
                color='#d62728', s=40, zorder=5)
    ax2.annotate(f'MDD: {max_dd_val:.2f}%',
                xy=(df.loc[max_dd_idx, 'Time'], max_dd_val),
                xytext=(15, -10), textcoords='offset points',
                fontsize=9, color='#d62728',
                fontweight='bold')

    ax2.set_ylabel('回撤 (%)', fontsize=11)
    ax2.set_xlabel('时间', fontsize=11)
    ax2.grid(True, alpha=0.3, linestyle='--')
    ax2.spines['top'].set_visible(False)
    ax2.spines['right'].set_visible(False)

    plt.tight_layout()
    return fig, (ax1, ax2)
5.2 回撤的三种口径
除了回撤深度,回撤持续时间和恢复时间也是重要的分析维度。回撤持续时间指的是从峰值跌到谷值用了多长时间,恢复时间指的是从谷值回到前期峰值用了多长时间。一个策略即使回撤深度不大,但如果恢复时间特别长,也会严重影响资金效率。
六、进阶图表1:绩效热力图
热力图是一种用颜色深浅来表示数值大小的可视化方式,非常适合展示时间维度上的周期性规律。在EA绩效分析中,最常用的热力图是月度收益热力图——行是年份,列是月份,每个格子的颜色深浅代表当月的收益多少。一眼就能看出哪些月份赚钱、哪些月份亏钱、有没有季节性规律。
6.1 月度收益热力图
绘制月度收益热力图需要先把逐笔交易数据聚合成月度收益率。我们使用pandas的resample功能来完成时间聚合,然后用seaborn的heatmap函数来绘制。
import seaborn as sns

def plot_monthly_returns_heatmap(df, title='月度收益热力图'):
    """
    绘制月度收益热力图(年份 x 月份)
    """
    # 按日期索引,计算日度收益
    df_daily = df.set_index('Time')[['Equity']].resample('D').last().dropna()
    df_daily['daily_return'] = df_daily['Equity'].pct_change()

    # 聚合成月度收益
    monthly_returns = df_daily['daily_return'].resample('M').apply(
        lambda x: (np.prod(1 + x) - 1) * 100
    )

    # 构建透视表:行=年份,列=月份
    monthly_df = pd.DataFrame({
        'year': monthly_returns.index.year,
        'month': monthly_returns.index.month,
        'return': monthly_returns.values
    })
    heatmap_data = monthly_df.pivot(index='year', columns='month', values='return')

    # 月份名称映射
    month_names = ['1月', '2月', '3月', '4月', '5月', '6月',
                   '7月', '8月', '9月', '10月', '11月', '12月']
    heatmap_data.columns = [month_names[m-1] for m in heatmap_data.columns]

    # 绘制热力图
    fig, ax = plt.subplots(figsize=(14, 6), dpi=150)

    sns.heatmap(heatmap_data,
                annot=True,        # 显示数值
                fmt='.2f',          # 数值格式
                cmap='RdYlGn',      # 红黄绿配色
                center=0,           # 以0为中心
                linewidths=0.5,    # 格子边框线
                linecolor='white',
                cbar_kws={'label': '月度收益率 (%)'},
                ax=ax)

    ax.set_title(title, fontsize=14, fontweight='bold', pad=15)
    ax.set_xlabel('')
    ax.set_ylabel('年份', fontsize=11)
    plt.tight_layout()

    return fig, ax
6.2 其他热力图应用
除了月度收益热力图,热力图在EA分析中还有很多其他应用场景:
- 周度收益分布热力图:行=星期几,列=小时,展示不同时间段的收益分布,发现策略在什么时间表现最好/最差。
- 胜率矩阵热力图:行=品种,列=时间周期,展示多品种多周期组合下的胜率分布,快速定位最优品种周期组合。
- 参数热力图:行=参数A,列=参数B,展示不同参数组合下的收益或夏普比率,用于参数优化的可视化。
七、进阶图表2:蒙特卡洛分布模拟
回测的结果只有一条资金曲线,但这条曲线是不是"运气好"跑出来的?如果交易顺序变了,结果会怎么样?这就是蒙特卡洛模拟要回答的问题。通过随机打乱交易顺序,我们可以生成成百上千条不同的资金曲线,从而了解策略收益的概率分布,评估策略的稳健性。
7.1 什么是蒙特卡洛模拟?
蒙特卡洛模拟之所以重要,是因为单条回测曲线可能存在"路径依赖"的幸运偏差。比如一个策略正好在回测初期遇到一波大行情赚了很多钱,后面即使亏也亏不到本金。但如果交易顺序反过来,先亏后赚,可能中间就已经爆仓了。蒙特卡洛模拟通过穷举(随机抽样)各种可能的交易顺序,帮你评估策略在不同路径下的生存能力。
7.2 蒙特卡洛模拟代码实现
下面的代码实现了蒙特卡洛模拟的核心逻辑,并绘制了两种可视化结果:蒙特卡洛分布直方图(展示最终收益的概率分布)和多条随机资金曲线图(展示不同路径的变化范围)。
def monte_carlo_simulation(df, n_simulations=1000, initial_balance=10000, seed=42):
    """
    蒙特卡洛模拟:随机打乱交易顺序,生成N条资金曲线
    返回:多条最终收益值、多条资金曲线数组
    """
    np.random.seed(seed)  # 固定随机种子,保证结果可复现

    trades = df['Profit'].values
    n_trades = len(trades)

    # 存储所有模拟的最终收益和完整曲线
    final_returns = []
    equity_curves = []

    for _ in range(n_simulations):
        # 随机打乱交易顺序
        shuffled = np.random.permutation(trades)
        # 计算累计净值
        cum_profit = np.cumsum(shuffled)
        equity = initial_balance + cum_profit
        equity_curves.append(equity)
        final_returns.append((equity[-1] / initial_balance - 1) * 100)

    return np.array(final_returns), np.array(equity_curves)

def plot_monte_carlo(final_returns, equity_curves, df,
                       title='蒙特卡洛模拟分布', n_simulations=1000):
    """绘制蒙特卡洛分布图(含直方图和置信区间)"""
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6), dpi=150)

    # 左图:最终收益分布直方图
    n, bins, patches = ax1.hist(final_returns, bins=50,
                                 edgecolor='white', alpha=0.7,
                                 color='#1f77b4')

    # 计算关键统计量
    mean_return = np.mean(final_returns)
    median_return = np.median(final_returns)
    percentile_5 = np.percentile(final_returns, 5)
    percentile_95 = np.percentile(final_returns, 95)
    win_rate = np.sum(np.array(final_returns) > 0) / len(final_returns) * 100

    # 标注关键线
    ax1.axvline(mean_return, color='#d62728', linestyle='--',
                linewidth=2, label=f'均值: {mean_return:.2f}%')
    ax1.axvline(median_return, color='#ff7f0e', linestyle='-.',
                linewidth=2, label=f'中位数: {median_return:.2f}%')
    ax1.axvline(percentile_5, color='#9467bd', linestyle=':',
                linewidth=2, label=f'5%分位: {percentile_5:.2f}%')
    ax1.axvline(0, color='black', linestyle='-', linewidth=1)

    ax1.set_title(f'最终收益分布 (N={n_simulations}次模拟)',
                  fontsize=12, fontweight='bold', pad=10)
    ax1.set_xlabel('最终收益率 (%)', fontsize=10)
    ax1.set_ylabel('出现次数', fontsize=10)
    ax1.legend(fontsize=9)
    ax1.grid(True, alpha=0.3, linestyle='--', axis='y')

    # 添加胜率文字
    ax1.text(0.02, 0.95, f'盈利概率: {win_rate:.1f}%',
             transform=ax1.transAxes, fontsize=10,
             verticalalignment='top',
             bbox={'boxstyle': 'round', 'facecolor': '#d1e7dd', 'alpha': 0.8})

    # 右图:多条随机资金曲线 + 置信区间
    time_steps = np.arange(equity_curves.shape[1])

    # 绘制部分随机曲线(避免图太挤,只画100条)
    n_plot = min(100, equity_curves.shape[0])
    indices = np.random.choice(equity_curves.shape[0], n_plot, replace=False)

    for idx in indices:
        ax2.plot(time_steps, equity_curves[idx],
                 color='#1f77b4', alpha=0.1, linewidth=0.8)

    # 绘制95%置信区间带
    lower = np.percentile(equity_curves, 2.5, axis=0)
    upper = np.percentile(equity_curves, 97.5, axis=0)
    median_curve = np.median(equity_curves, axis=0)

    ax2.fill_between(time_steps, lower, upper, alpha=0.3,
                     color='#ff7f0e', label='95%置信区间')
    ax2.plot(time_steps, median_curve, color='#d62728',
             linewidth=2, label='中位数曲线')

    ax2.set_title('随机资金曲线与95%置信区间',
                  fontsize=12, fontweight='bold', pad=10)
    ax2.set_xlabel('交易序号', fontsize=10)
    ax2.set_ylabel('账户净值 ($)', fontsize=10)
    ax2.legend(fontsize=9)
    ax2.grid(True, alpha=0.3, linestyle='--')

    plt.tight_layout()
    return fig, (ax1, ax2)
八、进阶图表3:交易散点图与分布图
资金曲线和回撤图看的是整体表现,热力图和蒙特卡洛看的是分布和概率。但如果想深入挖掘策略的微观特征——比如单笔交易的盈亏分布、持仓时间和收益的关系、风险收益比的分布情况——就需要用到散点图和分布图了。这些图表能帮你发现策略的隐藏特征,找到优化的方向。
8.1 盈亏分布直方图
盈亏分布直方图展示的是每一笔交易的盈亏金额的分布情况。通过观察分布的形态,你可以了解策略的盈利模式:是正态分布还是偏态分布?是赚小钱亏大钱还是赚大钱亏小钱?有没有肥尾现象?
def plot_profit_distribution(df, title='单笔交易盈亏分布'):
    """绘制盈亏分布直方图,标注均值、中位数、胜率"""
    profits = df['Profit'].values
    wins = profits[profits > 0]
    losses = profits[profits <= 0]
    win_rate = len(wins) / len(profits) * 100

    fig, ax = plt.subplots(figsize=(12, 6), dpi=150)

    # 分别绘制盈利和亏损的直方图
    ax.hist(wins, bins=30, alpha=0.7,
            color='#2ca02c', edgecolor='white', label='盈利交易')
    ax.hist(losses, bins=30, alpha=0.7,
            color='#d62728', edgecolor='white', label='亏损交易')

    # 标注关键统计量
    ax.axvline(np.mean(profits), color='#1f77b4', linestyle='--',
               linewidth=2, label=f'均值: {np.mean(profits):.2f}')
    ax.axvline(np.median(profits), color='#ff7f0e', linestyle='-.',
               linewidth=2, label=f'中位数: {np.median(profits):.2f}')
    ax.axvline(0, color='black', linestyle='-', linewidth=1)

    # 计算偏度和峰度
    from scipy import stats
    skewness = stats.skew(profits)
    kurtosis = stats.kurtosis(profits)

    ax.set_title(title + f' (胜率: {win_rate:.1f}% | 偏度: {skewness:.2f} | 峰度: {kurtosis:.2f})',
                 fontsize=12, fontweight='bold', pad=10)
    ax.set_xlabel('单笔交易盈亏 ($)', fontsize=11)
    ax.set_ylabel('交易次数', fontsize=11)
    ax.legend(fontsize=10)
    ax.grid(True, alpha=0.3, linestyle='--', axis='y')

    plt.tight_layout()
    return fig, ax
8.2 持仓时间 vs 盈亏散点图
持仓时间和盈亏的关系是一个非常有意思的分析维度。散点图的横轴是持仓时间(可以是分钟、小时或天),纵轴是盈亏金额。每个点代表一笔交易。盈利的用绿色,亏损的用红色。通过这张图,你可以发现很多有趣的规律——比如是不是持仓时间越短越容易赚钱?是不是持仓超过某个时间后亏损概率大幅上升?
8.3 R因子分布图
R因子分布是专业量化分析中的常用图表。它展示的是每笔交易以初始风险为单位的盈亏分布。R因子分布比盈亏金额分布更有意义,因为它消除了仓位变化的影响,能够更纯粹地反映策略的风险收益特征。
九、一键生成完整分析报告
学完了前面的各类图表,你可能会问:每次都要一个一个画图,然后手动拼到报告里,太麻烦了。能不能一键生成完整的分析报告?当然可以。本章我们就来把前面所有的图表封装到一个脚本里,实现"扔进去一个CSV,输出一整套报告"的效果。
9.1 报告生成脚本的整体架构
一个完整的EA回测分析报告脚本,通常包含以下几个模块:
- 数据读取模块:读取并清洗MT5导出的CSV数据
- 指标计算模块:计算各类绩效指标(年化回报率、夏普比率、卡玛比率等)
- 图表生成模块:生成所有分析图表并保存为PNG
- 报告组装模块:将指标和图表组装成HTML报告
def generate_full_report(csv_path, output_dir='report_output',
                          initial_balance=10000):
    """
    一键生成完整EA回测分析报告
    输入:MT5导出的CSV文件路径
    输出:包含所有图表PNG + HTML报告的文件夹
    """
    import os
    os.makedirs(output_dir, exist_ok=True)

    # 1. 读取数据
    df = load_mt5_trades_csv(csv_path, initial_balance)

    # 2. 计算绩效指标
    metrics = calculate_performance_metrics(df, initial_balance)

    # 3. 生成所有图表并保存
    fig1, _ = plot_equity_with_drawdown(df)
    fig1.savefig(os.path.join(output_dir, '01_equity_drawdown.png'),
                dpi=300, bbox_inches='tight')
    plt.close(fig1)

    fig2, _ = plot_monthly_returns_heatmap(df)
    fig2.savefig(os.path.join(output_dir, '02_monthly_heatmap.png'),
                dpi=300, bbox_inches='tight')
    plt.close(fig2)

    final_returns, equity_curves = monte_carlo_simulation(df, 1000, initial_balance)
    fig3, _ = plot_monte_carlo(final_returns, equity_curves, df)
    fig3.savefig(os.path.join(output_dir, '03_monte_carlo.png'),
                dpi=300, bbox_inches='tight')
    plt.close(fig3)

    fig4, _ = plot_profit_distribution(df)
    fig4.savefig(os.path.join(output_dir, '04_profit_distribution.png'),
                dpi=300, bbox_inches='tight')
    plt.close(fig4)

    # 4. 生成HTML报告
    html_content = generate_html_report(metrics, output_dir)
    with open(os.path.join(output_dir, 'report.html'), 'w', encoding='utf-8') as f:
        f.write(html_content)

    print(f'报告生成完成!保存在: {output_dir}')
    return metrics
9.2 用plotly生成交互式报告
如果你想要更酷炫的交互体验,可以用plotly来生成交互式报告。plotly生成的图表支持鼠标悬停看数据、框选放大、下载图片、切换图例等功能。下面是一个用plotly画交互式资金曲线图的示例:
import plotly.graph_objects as go
from plotly.subplots import make_subplots

def plot_interactive_equity(df, output_html='interactive_report.html'):
    """用plotly生成交互式资金曲线+回撤图"""
    fig = make_subplots(rows=2, cols=1,
                        shared_xaxes=True,
                        row_heights=[0.7, 0.3],
                        vertical_spacing=0.05)

    # 上图:资金曲线
    fig.add_trace(go.Scatter(x=df['Time'], y=df['Equity'],
                              mode='lines', name='账户净值',
                              line=dict(color='#1f77b4', width=2),
                              fill='tozeroy', fillcolor='rgba(31, 119, 180, 0.1)'),
                  row=1, col=1)

    # 下图:回撤
    fig.add_trace(go.Scatter(x=df['Time'], y=df['Drawdown_Pct'],
                              mode='lines', name='回撤 (%)',
                              line=dict(color='#d62728', width=1.5),
                              fill='tozeroy', fillcolor='rgba(214, 39, 40, 0.2)'),
                  row=2, col=1)

    fig.update_layout(
        title='EA回测绩效分析(交互式)',
        height=700,
        hovermode='x unified',
        legend=dict(orientation='h', yanchor='bottom', y=1.02),
        template='plotly_white'
    )

    fig.write_html(output_html)
    return fig
十、总结与进阶:回测可视化的推荐实践
文章到这里就接近尾声了。我们从环境搭建开始,讲解了三种数据获取方式,然后逐层深入——从基础的资金曲线图和回撤图,到进阶的热力图、蒙特卡洛模拟、散点分布图,最后整合为一键生成的完整分析报告。内容很多,但核心只有一个:用Python把MT5回测数据的价值最大化。
下面,我们总结5个回测可视化的推荐实践,帮你少走弯路,直接做出专业级的分析报告。
第1条:始终使用对数坐标展示长期资金曲线
当回测周期超过1年、累计收益超过50%时,线性坐标会导致早期的波动被压缩得看不清,给人一种"越到后面越赚钱"的错觉。对数坐标能真实反映不同阶段的收益率变化,让曲线的斜率更有可比性。判断是否该用对数坐标的简单标准:如果最终净值和初始净值差异超过2倍,就用对数坐标。
第2条:回撤图与资金图上下对齐,时间轴一致
这是专业绩效报告的标准布局——上图资金曲线,下图回撤水下图,共享同一个时间轴。这样读者可以一目了然地看到:资金曲线的某一段下跌对应的回撤有多深、持续了多久。如果把两张图分开,读者需要自己在脑子里对齐时间,体验会差很多。
第3条:热力图注意色盲友好配色,避免纯红绿对比
全球约有8%的男性是红绿色盲,纯红绿色系的热力图对他们来说完全无法区分。推荐使用RdYlGn(红-黄-绿,中间有黄色过渡)或RdYlBu(红-黄-蓝)等色盲友好的配色方案。也可以在颜色差异的基础上增加数值标注,这样即使颜色看不清,也能通过数字获取信息。
第4条:蒙特卡洛模拟至少跑1000次才有统计意义
次数太少的蒙特卡洛模拟结果不稳定,每次运行差异很大,反而容易误导决策。100次以下基本就是瞎看,1000次左右能得到大致的分布形态,5000次以上结果比较稳定。对于正式报告和客户交付,建议跑5000-10000次。记得设置随机种子,确保结果可复现。
第5条:报告同时提供静态PNG和交互式HTML两个版本
静态PNG适合嵌入PPT、打印PDF、发给客户查看,优点是打开即看,不需要任何额外软件。交互式HTML适合自己深入分析,可以悬停查看数据、框选放大、切换图例。两种版本各有优势,同时提供能覆盖大多数使用场景。
进阶展望
掌握了基础的回测可视化之后,还有很多进阶方向可以探索:
- Web仪表板:用Dash或Streamlit搭建在线分析平台,上传CSV即出报告,支持多用户使用。
- 实时监控看板:结合MT5的实时账户数据,打造实盘绩效实时监控大屏,动态更新资金曲线和风险指标。
- 多策略组合可视化:同时展示多个EA的绩效对比,包括相关性矩阵、组合收益分解、风险贡献度等高级分析。
- 参数优化可视化:将参数扫描的结果用三维曲面图或热力图展示,直观看到参数变化对绩效的影响。
最后,回到文章开头的问题:为什么MT5自带的回测报告不够用?因为它只是一个"结果展示",而专业的回测可视化是一种"分析工具"。前者让你知道"赚了多少钱",后者帮你理解"为什么赚、怎么赚的、还能不能继续赚"。这中间的差距,就是普通EA用户和专业量化交易者的差距。
希望本文提供的代码和方法论,能帮你建立起自己的EA回测可视化工具链,让你的分析报告提升一个档次。也欢迎关注晓辉编程,我们会持续分享更多MQL5编程和EA开发的干货内容。

微信公众号
晓辉编程

视频号
晓辉说EA


